

400-820-8531
 图1. 由于质谱的球胆固醇组学概括(图源:Shuken, J Proteome Res, 2023)
01.数据报告定量分析:多肽认定
一次LC-MS/MS正常运作呈现的原史资料集都是个大的光谱仪仪子集,每家光谱仪仪都存在抹去用时、m/z值、強度和元资料。适用MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等免费软件包加工哪些资料,转换肽和/或核脂肪酸表单,每家辨别的都存在个积分。大绝对多数数非靶向治疗的自下而上的DDA核脂肪酸组学研究中适用的最易见的肽评定的方式为资料库搜到(图2)。
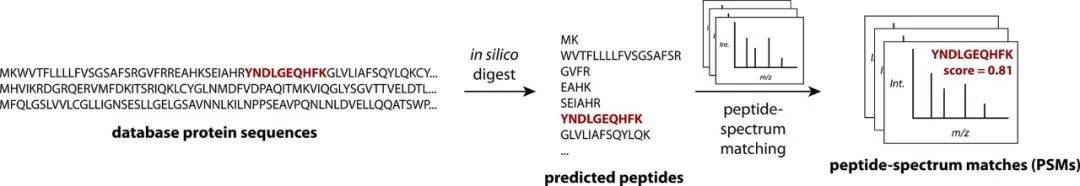 图2. 大比对数据库快速搜索的优化分析(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的安基酸编码序列(图源:Shuken, J Proteome Res, 2023)
 图4. 电影电影片段m/z值、带引用的MS2谱,及及图3中凸起凸显的电影电影片段队列(NILIDFTK)
1.1 数据库视图库快速搜索算法为基础范本:SEQUEST的简易描素
SEQUEST是1998年出版界的首例全系统自动肽自动识别平台。图5操作了SEQUEST聚类算法的简易化基本概念。第一方面,对借鉴蛋白酶质组分折的肽去滤过,尽可能只注意与转移的断了亚铁亚铁离子的m/z值形似的前体(即正电荷动态特情人肽亚铁亚铁离子),那么转成认识论光谱图图分析仪分析图仪图仪图分析(图5,表层)。借助将實驗光谱图图分析仪分析图仪图仪图分析与分折精彩精彩片段的m/z值去直观非常,认识论光谱图图分析仪分析图仪图仪图分析被最快滤过,适应精彩精彩片段的数目、MS2抗拉屈服承载力和多种一些功能组成成一高考成绩排名,仅留下依托于该高考成绩排名的前500个认识论光谱图图分析仪分析图仪图仪图分析(图5,工作过程1)。借助排除前体峰,将光谱图图分析仪分析图仪图仪图分析界定为5个一一对应的部位,并将所有部位的抗拉屈服承载力归一化成差不多的值来调准實驗光谱图图分析仪分析图仪图仪图分析(图5,工作过程2),这这一步使實驗光谱图图分析仪分析图仪图仪图分析更贴近认识论光谱图图分析仪分析图仪图仪图分析,减低了创设认识论光谱图图分析仪分析图仪图仪图分析时移除的可变性皮肤信息爆炸吸收率的。借助将所有m/z值处的抗拉屈服承载力相乘并将乘积一起,算實驗光谱图图分析仪分析图仪图仪图分析与所有认识论光谱图图分析仪分析图仪图仪图分析当中的之间关联(图5,工作过程3)。
 图5. 要学会简化了原SEQUEST数据文件库搜索网页算法流程图的措施(图源:Shuken, J Proteome Res, 2023)
1.2 肽签定中的FDR掌控
让我们是怎样来决定些什么成绩有足够高来表示法逼真的ID?现就要,最流行歌曲的技术是 Target-decoy搜(图6)。该时抑制缺省误区显示率(FDR),即被介绍的PSM误区的分別分配比例。想要在抑制FDR的此外明显容许地测量真肽,还可以实用搜成绩和PSM的多种特证的波形組合(图6)。波形組合中实用的标准值{a, b,…}被整合以明显容许地测量真肽,平常实用percolator实用的POS机掌握优化提升算法。在这整合来完成后,拥有不超所必需FDR相应的阀值的最终目标识别(假如,1%)被恢复。这是油烟净化器数据库集的FDR誉为“缺省”FDR。
 图6. Target-decoy手机搜索。PSM=肽谱适配;FDR =错误信息发现了率(图源:Shuken, J Proteome
02.肽段参考值
有效率高效益高效液相色谱在所有工作具体步骤中很多次地将多肽打药到质谱仪中。各个扫描机时间是以此,一般性都要3 s或愈少,光谱分析图仪出现MS1光谱分析图;但是,在有效率高效益高效液相气相色谱柱洗刷具体步骤中,前体的MS1峰时常被观察动物到很多次,一些MS1数据统计点在一起出现色谱峰(图7A)。给定某的肽,其色谱峰的表现形式,与其对高度或申请这类卡种曲线提额后面积(AUC),能作于检测的肽的对丰度,这被成为料框记化学发光法(LFQ),该办法能作于各不相同样件中的次数较好。 方便增加降钙素原检测初现性、供试品通量和/或数据统计完整版性,标识化学反应试剂都行于降钙素原检测同个质谱中的2个生态学供试品。在这部分策略中,用来区别的放射性拉曼光谱图引发肽或其情节的m/z值区别外,肽被标识为一致的氧原子群,时候继承化学反应质地,如继承时段、电离性和情节基本模式。在分解代谢标识策略中,如受损细胞培养出酪氨酸稳定的放射性拉曼光谱图标识(SILAC),利用率生态学系统化将有重放射性拉曼光谱图的酪氨酸标识正个蛋清质组。在供试品制作开启时,将天然植物“轻”蛋清与重蛋清结构,那么呢与MS1光谱图便用非常(图7B)。在等压法(即品质一样,鉴于区别的标注具备有一致的总品质)标识策略中,如并联品质标注(TMT),肽段在消化系统后被标识,那么呢在LC-MS/MS前结构。一般CID(HCD)为每一位生态学供试品缓解压力区别的该报告格式铁铁离子;确认MS2或MS3扫苗检测该报告格式铁铁离子硬度,行测算出对应丰度(图7C)。便用LFQ,每晚运作分享个生态学子样例;便用SILAC,每晚运作经常分享两到6个生态学子样例;便用TMT,一次性行分享多大18种区别的生态学子样例。
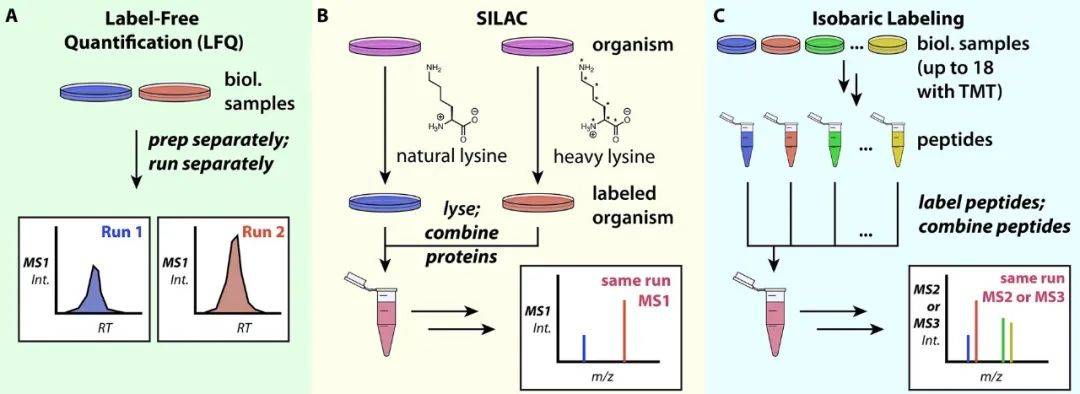 图7. 多肽酶联免疫法方式 。A.在MS1技术进行非标设备记酶联免疫法;B. 癌细胞培植中氨基稳固拉曼光谱记号(SILAC);C. 等压记号
03.“蛋清质的水平”:测算蛋清质的基本特征和丰度
3.1 氨基酸质推算与分成小组
也许很多的适用自下而上球氨基酸组学谈及了“球氨基酸”的生份和數量,但她们基本是签别和/或评定球氨基酸群,其发源的球氨基酸或人类基因可以是不清楚的。来说一种语病,通较为常见的来解决设计方案是的适用任何PSM用作试样中会存在一定球氨基酸的书证。这样一种球氨基酸两者之间有一一对应的书证(即球氨基酸队列与同种种签别的肽队列识别,如图所示8中的球氨基酸V和VI),则将这个球氨基酸三人组合为这个球氨基酸组(PG)。这样这个球氨基酸的识别肽是另这个球氨基酸的子集,则该球氨基酸基本被解决在计划书后,而由于缺乏该球氨基酸独特肽但其肽不子集的球氨基酸叫做可分为球氨基酸。
 图8. 蛋清质测算和组群方式(图源:Shuken, J Proteome Res, 2023)
3.2 球蛋白技术FDR设定
基本上都数实施蛋清质分类的受欢迎游戏包,如MaxQuant和Proteome Discoverer,也会算起蛋清质品质评定FDR的估摸着,并将其再一次改变到可配受的品质。有多个形式会有效控制蛋清质品质的FDR。的会直接的战略是借助钓饵PGs,即已经由钓饵PSM组合而成的PG,我们被自己提取并面临与关键PSM同样的蛋清质推断出流程。为每两个关键和钓饵PG营造两个中考分数,能接受以与PSM FDR类似于的的方式有效控制蛋清质品质FDR(图6)。3.3淀粉酶组降钙素原检测
多肽和球营养素内密切关系的双方位主观因素使某一期间繁复化。PG内的肽也许 在她们适应的球营养素中你我各不相同,这也许 会直接的影响她们的丰度(图8)。如果PG中的肽是该PG所代表性的,是有助力的,同意对单独某个球营养素做考评。殊不知,繁复的是肽也许 生产于具有刺激性反译后修饰语的球营养素,其丰度直接的影响肽的程度,不但,会因为DDA具有的随机函数性,很多肽也许 在一款 土样中考察植物到而在另外款 土样中考察植物不来。风靡的动态统计数据治疗pc游戏包为普通用户打造了解到决这种毛病的工具栏。多半数pc游戏(主要包括MaxQuant)只同意对PG-unique肽做化学发光法。很多(如Spectronaut ,Biognosys)同意较多的品种,如限止化学发光法到球营养素活性聊天肽,或的选择是否是用到肽程度的中六个数、和、数学算起月均的值或图形月均的值来算起PG用量。谈谈LFQ,指的关注的是MaxQuant中控制的风靡的MaxLFQ计算工艺。当在各不相同的范本中正常识别出各不相同的前体集时,MaxLFQ能够适用用于的两两特别和用到中六个数占比来特别PG来治疗短缺值。等压标注和动态统计数据独特抓取(DIA)是下降或消去短缺值的其他的工艺。3.4 统计表探讨和微植物学表达
若是算出PG的相对而言数目,结合工作英文的生物科技学优点,能选择各式专用工具对结局做出的数据总计统打深入数据总计定量分析汇总具体深入数据总计定量分析和解说。Perseus和MSStats是设计的应用在球蛋白酶质组数目操作和的数据总计统打深入数据总计定量分析汇总具体深入数据总计定量分析的受欢迎PC软件包。的数据总计也能选择程序编程话述(如python或R)人工操作具体深入数据总计定量分析。在普通有点球蛋白酶质组学工作英文中,有从目录中清掉弄脏物或耳料,选择对数计算使数目类似正态分布图制作,将的数据总计归一化以改善正常运作间的科技进化性,选择的数据总计统打深入数据总计定量分析汇总检定(如t检定/方差具体深入数据总计定量分析/规则化归队)检定變化,并对结局p值做出多统计假设检定。 调查统记确定解析做完后,結果会确定菌物学定义。Gene Ontology是探讨在检测性中发生了影响的菌物途经的其中一个时兴数据统计库。STRING带来了关于兴趣爱好爱好的血清质中如图所示完美干系或完美做用的讯息。涉及到的确定解析,如加权平均染色体涉及到的系统上确定解析(WGCNA),选择检测性中血清质丰度变化无常的相拟的程度搭配血清质系统上,这会更进一步一个脚印熟知检测性中血清质中的完美干系。借助整合定义这个确定解析的結果,菌物学举个例子会达到适配或争辩,还有就是会引发新的举个例子。04.拜谱生物体归纳总结:质谱做工作程序流程
总的说,料框记的自下而上的事情的流程内容如下: (1)隔离阻止/草木、融解人体细胞;用磷酸二氢钾和/或去垢剂使蛋白酶质转性。 (2)用DTT或TCEP等方式 才能减少二混炼物;用IAA烷基化半胱氨酸。 (3)用冷二甲苯、氯仿-甲醇石雕文化沉淀自己法或磁珠石雕文化沉淀自己法部门纯化淀粉酶质(有点运转程序不动用有危害性的去垢剂如SDS,可关掉这一个步骤)。 (4)用胰血清酶或LysC组和血清酶消化酶血清质。 (5)用C18包被的过滤水吸管头离心法法拆洗/脱盐多肽;用进口真空离心法法机等多效蒸发液体。 (6)将肽重悬于LC-MS兼容的有机溶剂中,诸如0.1%甲酸水液体;使用相关联的测试仪器手段展开LC-MS/MS深入分析;在启动完整后索引原来动态数据。 (7)应用适合使用的手机app包治理原有数据资料库,如MaxQuant或Proteome Discoverer,或手机app包的搭配组合,实行数据资料库库快速搜索、FDR调整、相对应降钙素原检测和血清质推测。 (8)食用编译程序表达(如python或R)或app包(如Perseus或MSStats)执行工作数据汇总深入分析。 (9)结合科学试验的生物制品学操作过程来说明的结果;这也可以能够 根目录或电脑网络级定性分析資源(如Gene Ontology、STRING或WGCNA)来协助。 05前沿性主题图片
不仅有DDA完成的非靶向治疗治疗自下而上的无箭头符号血清质组,另外 大多的特征提取质谱的做法来探析血清质组(图9)。实验仪器和数学模型均在推陈出新的不断更新,删改篇血清质、由上而下和纯天然质谱法也采用深入分析一下低麻烦性的样品;血清的汉语翻译后呈现故有至关更重要的调整功效占有宽阔的探析大地。设备构造血清质组学、生物物质血清质组学和比较接近于箭头符号等技艺采用生物物质、酶或热技艺来发现血清质,为探析血清质设备构造、生物物质、追踪定位、血清质-配体互不功效或血清质-血清质互不功效建立了过量的概率。不同于DDA,大信息自立收采(DIA)有的是种越多越受喜欢的收采做法,最流行时尚的DIA做法是特征提取SWATH-MS,在这当中各个MS1面积内的各个m/z值在一个扫苗寿命内都包含了在震碎的碎片中,这大大的增长了大信息删改篇性,增添了血清质组学深浅。在靶向治疗治疗血清质组学中,的一种当前的血清质或一组组血清质被看作深入分析一下的目的,其目的是保证 每天做法进行时都能检测工具到目的血清质(大信息删改篇高朝),最高残留量地增长灵巧度和动态信息面积,及一定量精确度性和五金机械度。 而对于大经营规模的营养素质签定和定量分析,质谱法是迄今为止最留行的方案,在在未来,质谱与别的非质谱能力的构建安全使用能否深些入地理解一个微生物中的营养素质组。
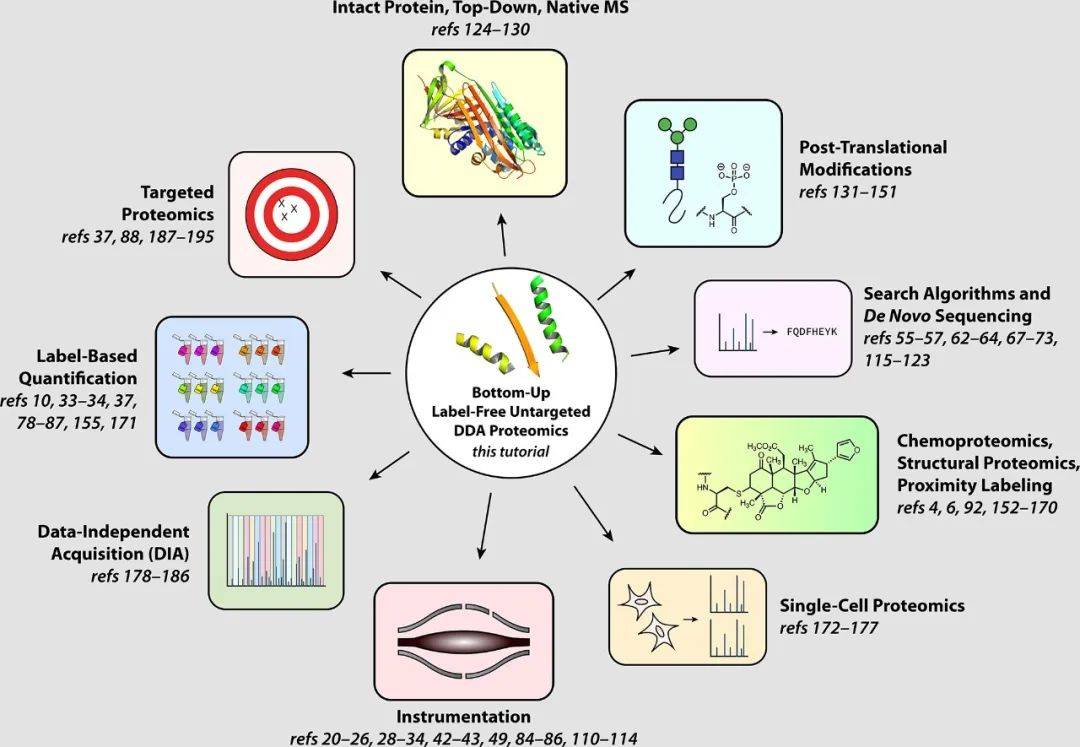 图9. 依托于质谱的球蛋白组学的子行业领域(图源:Shuken, J Proteome Res, 2023)
参照文献综述:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 青睐媒体号


 关心小华书


